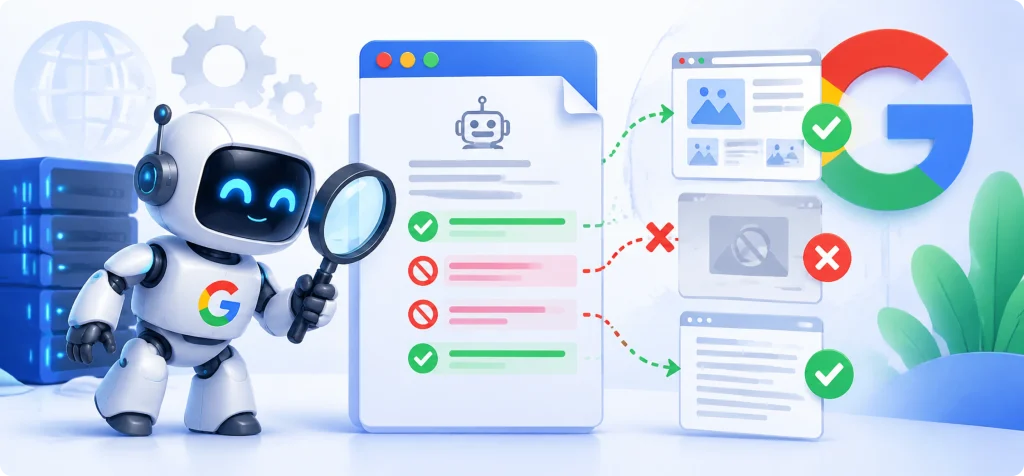

En robots.txt fil forteller søkemotorroboter hvilke URL-er de kan gjennomsøke på nettstedet ditt. Det er en ren tekstfil plassert i roten av nettstedet ditt, og kompatible roboter sjekker den før de gjennomsøker URL-er.
Den viktige forskjellen er at robots.txt ikke er en “skjul denne siden fra Google” knapp. Google forklarer at robots.txt hovedsakelig brukes til å administrere robottilgang og unngå å overbelaste et nettsted med forespørsler; det er ikke en pålitelig måte å holde en side ute av Google Søk.
Denne misforståelsen kan føre til problemer med gjennomsøking og indeksering. Denne veiledningen forklarer hva robots.txt gjør, når du skal bruke den, og når du bør bruke verktøy som noindex eller passordbeskyttelse i stedet.
Viktige konklusjoner
- Robots.txt kontrollerer om roboter kan gjennomsøke en URL. Den kontrollerer ikke indeksering.
- En blokkert side kan fortsatt vises i Google Søk hvis andre nettsteder lenker til den.
- For å holde en tilgjengelig side ute av Google Søk, bruk noindex, og Google må kunne gjennomsøke siden for å se den.
- Filen må ligge i roten av domenet ditt: https://example.com/robots.txt.
- Hvem som helst kan lese robots.txt filen din, så aldri oppgi private nettadresser i den.
- De fleste små nettsteder trenger bare noen få enkle regler, eller ingen i det hele tatt.
Hva er en Robots.txt fil?
Robots.txt er en tekstfil som gir instruksjoner til webcrawlere. Søkemotorcrawlere som er kompatible, sjekker robots.txt før de crawler URL-er på nettstedet ditt.
Den ligger i roten av domenet ditt:
- https://dittfirma.no/robots.txt
Den må hete robots.txt og plasseres i roten av den aktuelle verten. Crawlere ser ikke etter den i en undermappe.
Filen er også offentlig. Hvem som helst kan skrive inn domenet ditt pluss /robots.txt og lese den. Så det er et dårlig sted å nevne administrasjonspaneler eller stagingområder.
Hvordan fungerer Robots.txt med Googlebot?
Googlebot finner URL-er via lenker, nettstedskart og tidligere gjennomsøkinger. Før den ber om en URL, sjekker den robots.txt filen din for regler som gjelder.
Hvis en URL ikke er tillatt, gjennomsøker Googlebot den vanligvis ikke.
Google kjører forskjellige roboter for forskjellige jobber, og regler kan målrette dem med brukeragenttoken. De fleste nettsteder trenger bare regler som gjelder for alle.
Hovedpoenget er det samme. Robots.txt påvirker om en robot henter en side. Den avgjør ikke om URL-en vises i søkeresultatene.
Gjennomsøking vs. indeksering: Forskjellen som betyr noe
Det er her de fleste robots.txt feilene begynner, så det er verdt å være presis.
- Gjennomsøking betyr at Googlebot ber om og laster ned en URL.
- Indeksering betyr at Google lagrer informasjon om den URL-en og kan vise den i Søk.
Gjennomsøking og indeksering er forskjellige prosesser. Å blokkere gjennomsøking med robots.txt forhindrer ikke indeksering på en pålitelig måte.
Google kan ikke gjennomsøke innholdet i en URL som er blokkert av robots.txt, men de kan fortsatt indeksere URL-en selv hvis de oppdager den gjennom lenker eller andre kilder. I så fall kan URL-en og potensielt annen offentlig informasjon, for eksempel ankertekst, vises i Google Søk.
For eksempel blokkerer en nettbutikk /gammel-kampanje/ fordi de vil at siden skal fjernes fra Google. Googlebot slutter å gjennomsøke den, men et gammelt blogginnlegg lenker fortsatt til URL-en. Google kan derfor beholde URL-en i indeksen sin og vise den i Søk uten en vanlig sidebeskrivelse.
Sideinnholdet kan ikke gjennomsøkes, men URL-en kan fortsatt vises i Søk.
Målet ditt |
Bruk |
| Kontroller om en robotsøkeprogram henter en URL | robots.txt |
| Hold en tilgjengelig side ute av Google Søk | noindex |
| Beskytt privat eller konfidensielt innhold | Passordbeskyttelse/autentisering |
| Hjelp søkemotorer med å oppdage viktige URL-er | XML-nettstedskart |
| Sjekk om Google kan gjennomsøke en side | Google Search Console |
Kan Robots.txt fjerne en nettside fra Google?
Ikke pålitelig. Robots.txt kontrollerer gjennomsøking; det er ikke standardmetoden for å fjerne en nettside fra Google Søk. Den kontrollerer om gjennomsøkere kan få tilgang til URL-en. Hvis Google allerede kjenner URL-en fra lenker eller andre kilder, kan URL-en fortsatt vises i Søk selv når gjennomsøking er blokkert.
For å forhindre at en tilgjengelig side vises i Google Søk, bruk noindex. For privat eller konfidensiell informasjon, bruk passordbeskyttelse eller en annen tilgangskontrollmetode.
Hvorfor du ikke kan kombinere Robots.txt og Noindex
Dette kan også føre til at erfarne personer blir snublet. Hvis du blokkerer en side i robots.txt og legger til en noindex tag, kan det hende at Google aldri ser noindex instruksjonen.
Prosessen er:
- Robots.txt blokkerer Googlebot fra å gjennomsøke siden.
- Googlebot kan ikke hente siden.
- Googlebot kan ikke se noindex direktivet.
- URL-en kan fortsatt vises i Søk hvis Google oppdager den andre steder.
Grunnleggende Robots.txt-regler
Brukeragent
Navner robotsøkeprogrammet en regel gjelder for. En stjerne betyr alle robotsøkeprogrammer.
Brukeragent: *
Ikke tillatt
Blokkerer gjennomsøking på en bane.
Ikke tillatt: /wp-admin/
Dette blokkerer alt som starter med /wp-admin/.
Tillat
Oppretter et unntak i en blokkert bane.
Ikke tillatt: /wp-admin/
Tillat: /wp-admin/admin-ajax.php
Mappen er blokkert, men den ene filen forblir gjennomsøkbar.
Jokertegn
* samsvarer med en hvilken som helst tegnsekvens. $ markerer slutten på en URL.
Ikke tillatt: /*?sort=
Ikke tillatt: /*.pdf$
Den første blokkerer URL-er som inneholder den parameteren. Den andre blokkerer URL-er som slutter på .pdf.
Nettstedskart
Peker robotsøkeprogrammer til XML nettstedskartet ditt. Det hjelper søkemotorer med å oppdage URL-er, men det garanterer ikke gjennomsøking eller indeksering.
Robots.txt kontrollerer tilgangen til roboter, mens et nettstedskart hjelper søkemotorer med å oppdage nettadresser du vil at de skal vurdere.
Nettstedskart: https://dittfirma.no/sitemap.xml
Et enkelt Robots.txt eksempel
For de fleste nettsider for små bedrifter er dette nok:
Brukeragent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s
Nettstedskart: https://dittfirma.no/sitemap.xml
Linje for linje: alle roboter er dekket, admin mappen er blokkert, én fil i den forblir tilgjengelig, og WordPress søke URL-er som inneholder s parameteren, for eksempel /?s=shoes, er blokkert. Nettstedskartet er også deklarert.
Alt annet på nettstedet forblir gjennomsøkbart. Det er bevisst.
Når bør du bruke Robots.txt?
Start med ett spørsmål: Kontrollerer jeg gjennomsøking, indeksering eller tilgang?
Robots.txt håndterer gjennomsøking. Gode bruksområder:
-
- Interne søkeresultatsider, som lager uendelige URL-er med lav verdi
- Filtrer og sorter parametere, spesielt i en nettbutikk med mange filtre
- Kalender sider som genererer uendelige datoer
- Duplikate URL-er eller URL-er med lav verdi som genererer unødvendige forespørsler fra robotsøkemotoren
Legg merke til hva disse deler. Dette er ikke sider du vil fjerne fra Google. Dette er URL-er som ikke er verdt en robotsøkemotors tid.
Når bør du ikke bruke Robots.txt?
- For å skjule privat informasjon. Filen er offentlig og er ikke en sikkerhetskontroll. Passordbeskytt alt som er konfidensielt.
- Som din noindex metode. Å blokkere siden hindrer Google i å lese noindex.
- For å blokkere CSS eller JavaScript tilfeldig. Google kan bruke disse ressursene til å gjengi og forstå en side. Å blokkere ressurser som er viktige for gjengivelse kan gjøre det vanskeligere for Google å forstå siden.
- For å jage rangeringer. Robots.txt er ikke et rangeringsverktøy. Færre gjennomsøkte sider betyr ikke høyere plasseringer.
Vanlige feil
- Blokkering av hele nettstedet. En tilfeldig Disallow: / under User-agent: * kan blokkere Googlebot fra å gjennomsøke hele nettstedet ditt og forhindre Google i å få tilgang til sidene dine for indeksering.
- Glem WordPress-innstillingen. “Fraråd søkemotorer fra å indeksere dette nettstedet” i Innstillinger → Lesing blokkerer hele nettstedet ditt. Sjekk det etter hver oppstart.
- Blokkering av en side som har en noindex-tag. Taggen blir usynlig.
- Listing av private stier. Å plassere /kunde-dokumenter/ i en offentlig fil forteller folk nøyaktig hvor de skal lete.
- Feil stier. Disallow: /Blog/ blokkerer ikke /blog/. Stier skiller mellom store og små bokstaver.
- For komplisert. Lange regellister er vanskeligere å revidere og lettere å gjøre feil.
Slik sjekker du Robots.txt filen din
- Åpne domenet ditt etterfulgt av /robots.txt i en nettleser.
- Filen skal være tilgjengelig i roten av den relevante verten, for eksempel https://example.com/robots.txt.
- Les hver Disallow linje og spør hva den blokkerer.
- I Google Search Console bruker du URL inspeksjon på noen viktige sider for å bekrefte at Google kan gjennomsøke dem.
- Sjekk sideindekseringsrapporten for URL-er som Google har oppdaget, men ikke kan gjennomsøke på grunn av robots.txt. Dette kan bidra til å identifisere URL-er som er kjent for Google, men blokkert fra gjennomsøking.
- Sjekk på nytt etter enhver migrering, redesign eller plattformendring.
Det siste trinnet kan fange opp alvorlige gjennomsøkingsproblemer før de påvirker synligheten din.
Robots.txt på WordPress, Shopify og andre plattformer
CMS-et ditt kan generere eller administrere robots.txt automatisk. WordPress og SEO pluginer kan gi måter å administrere filen på, mens Shopify kontrollerer mye av robots.txt oppførselen. Sjekk plattformens gjeldende dokumentasjon før du legger til tilpassede regler.
Google sier det samme: med noen plattformer trenger eller kan du kanskje ikke redigere robots.txt direkte, og CMS-et kan tilby en søkeinnstillingsside i stedet.
Så finn ut hva plattformen din allerede gjør før du skriver tilpassede regler. Å legge til tilpassede regler uten å sjekke den eksisterende konfigurasjonen kan ved et uhell blokkere viktige URL-er.
Forbedrer Robots.txt SEO?
Nei. Robots.txt forbedrer ikke direkte søkerangeringer. Det kan bidra til å administrere crawler tilgang og redusere unødvendig crawling på store nettsteder, men det gjør ikke at svakt innhold rangerer høyere.
En riktig konfigurert fil kan forhindre unødvendig crawling og utilsiktede tilgangsbegrensninger. Det kan hjelpe store nettsteder med å administrere crawler aktivitet ved å begrense tilgangen til URL-er som ikke trenger å crawles.
Det vil ikke gjøre at svakt innhold rangerer bedre. For et nettsted for små bedrifter med bare noen få dusin sider, utgjør det ofte liten praktisk forskjell. Det realistiske målet: Ikke blokker det som betyr noe, og ikke forvent en økning i rangeringen.
Trenger du en Robots.txt-fil?
Nei. Et nettsted trenger ikke en robots.txt-fil for å bli gjennomsøkt eller indeksert. Hvis du vil at søkemotorroboter skal få tilgang til hele nettstedet ditt, kan du la filen stå tom eller ikke ha en i det hele tatt. Robots.txt blir nyttig når du trenger å administrere robotens tilgang til bestemte nettadresser eller seksjoner.
Sjekkliste før du redigerer
- Kontrollerer jeg gjennomsøking, indeksering eller tilgang?
- Må noe jeg blokkerer gjennomsøkes?
- Har siden en noindex tagg som jeg ville skjule?
- Er banen stavet og brukt riktig med store og små bokstaver?
- Er dette faktisk privat? Bør det i stedet være passordbeskyttet?
- Administrerer CMS-et mitt allerede denne filen?
- Har jeg testet viktige nettadresser i Search Console etterpå?
Avsluttende tanker
Robots.txt er en liten fil som kan gjøre reell skade. Én feil linje kan forhindre Googlebot i å gjennomsøke hele nettstedet ditt, og kan til slutt forårsake alvorlige synlighetsproblemer. Før du redigerer, vær tydelig på hva du ønsker. Å blokkere en gjennomsøker og fjerne en side fra Søk er forskjellige jobber med forskjellige verktøy. De fleste små nettsteder trenger svært lite her, og en kort, korrekt fil slår en lang en som ingen har gjennomgått siden lanseringen.
Trenger du hjelp med gjennomsøking eller indeksering?
Hvis du er usikker på hvorfor viktige sider mangler fra Google, kan Seostrategi.no gjennomgå ditt tekniske SEO oppsett og identifisere potensielle problemer med gjennomsøking og indeksering.
Ta kontakt med oss for å finne og fikse problemet.
Vanlige spørsmål
Stopper robots.txt Google fra å indeksere en side?
Nei. Google oppgir at de fortsatt kan finne og indeksere en ikke tillatt URL hvis den er lenket fra et annet sted på nettet, og URL-en og offentlig informasjon som ankertekst kan fortsatt vises i resultatene. Bruk noindex eller passordbeskyttelse i stedet.
Hva er forskjellen mellom robots.txt og noindex?
Robots.txt kontrollerer om en robotsøkeprogram kan hente en URL. Noindex forteller Google at den ikke skal vise en tilgjengelig side i Søk. De løser forskjellige problemer og bør ikke kombineres på samme side.
Kan jeg blokkere Googlebot med robots.txt?
Ja, ved bruk av User agent: Googlebot etterfulgt av reglene dine. Anerkjente robotsøkeprogrammer respekterer det. Ondsinnede roboter ignorerer det fullstendig, og det er derfor robots.txt ikke er et sikkerhetstiltak.
Hva skjer hvis jeg blokkerer hele nettstedet mitt?
Disallow: / under User-agent: * blokkerer gjennomsøking av nettstedet. Google kan fortsatt vite om noen URL-er, men de kan ikke gjennomsøke innholdet deres. Dette kan forårsake alvorlige indekserings- og synlighetsproblemer.
Er robots.txt et sikkerhetstiltak?
Nei. Robots.txt er offentlig og hindrer ikke folk i å få tilgang til URL-er. Den gir bare gjennomsøkingsinstruksjoner til kompatible gjennomsøkingsprogrammer. Bruk autentisering eller passordbeskyttelse for privat informasjon.
Trenger alle nettsteder en robots.txt fil?
Mange nettsteder bruker en enkel robots.txt fil for å deklarere nettstedskartet sitt eller administrere spesifikke gjennomsøkingsregler, men et nettsted trenger ikke en hvis det ikke er behov for spesielle gjennomsøkingsbegrensninger.
Hvordan sjekker jeg om Googlebot er blokkert?
Bruk URL inspeksjonsverktøyet i Google Search Console på en bestemt side. Det viser om Google kan gjennomsøke URL-en og flagger eventuelle robots.txt blokkeringer.