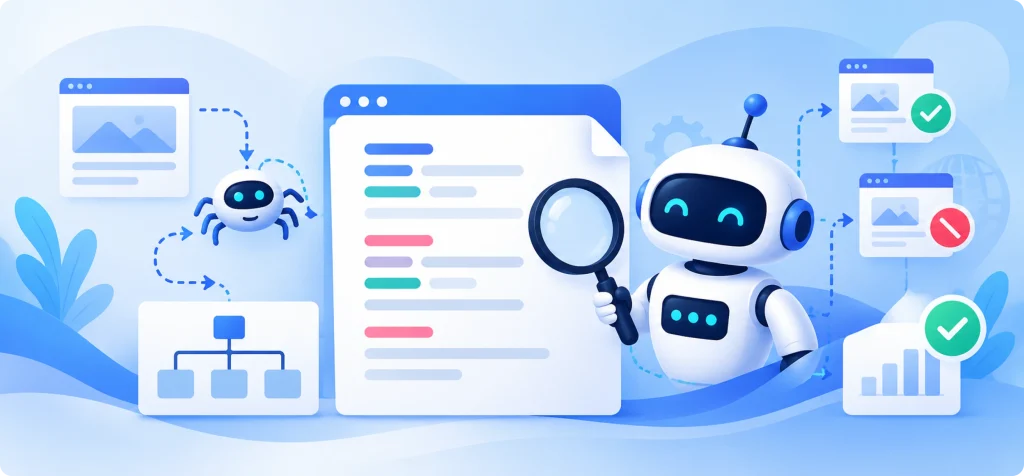

Robots.txt er en enkel tekstfil som forteller søkemotorenes crawlere hvilke deler av nettstedet ditt de kan crawle. Filen må være tilgjengelig i roten av det aktuelle domenet eller verten, og Google sjekker den når de avgjør hvilke nettadresser de kan crawle.
Viktige punkter
- Robots.txt er en tekstfil som gir crawlere instruksjoner om hvilke nettadresser de kan crawle.
- Den ligger i roten av domenet ditt, for eksempel https://example.no/robots.txt.
- Google sier at robots.txt ikke er en pålitelig måte å holde en side ute av Google Søk på.
- En blokkert side kan fortsatt vises i søkeresultatene hvis andre nettsteder lenker til den.
- De fleste små bedriftsnettsteder trenger svært lite her, og mange trenger ingen robots.txt i det hele tatt.
- En manglende robots.txt fil er vanligvis helt greit. En feilkonfigurert eller utilgjengelig fil kan føre til problemer med crawling.
- Robots.txt er ikke en rangeringsfaktor. Den kan ikke få nettstedet ditt til å klatre i søkeresultatene.
Hva er robots.txt?
Robots.txt er et sett med instruksjoner for automatiserte programmer som besøker nettsteder.
Tenk på den som et skilt ved inngangen til en bygning. Skiltet forteller besøkende hvilke korridorer de kan gå gjennom. Crawlere som følger reglene, leser skiltet og følger instruksjonene. Noen crawlere kan ignorere robots.txt fordi filen ikke er et sikkerhetstiltak.
Google sier tydelig at det er opp til crawleren å følge reglene. Seriøse crawlere gjør det. Scraping roboter og andre som misbruker nettsteder, gjør det ofte ikke.
Selve filen er enkel. Ingen kode eller programmering. Bare noen få tekstlinjer som lagres på ett bestemt sted.
Hvorfor er robots.txt viktig?
Det ærlige svaret er at den betyr mindre enn mange tror for de fleste små nettsteder.
Det egentlige formålet er å håndtere trafikken fra crawlere. Hvis du driver et stort nettsted, kan crawlere som besøker tusenvis av URL-er med liten verdi, belaste serveren unødvendig. Robots.txt lar deg styre dem bort fra slike områder.
Her kan den faktisk være nyttig:
- Store nettbutikker. URL-er for filtrering og sortering kan raskt bli mange. En klesbutikk med filtre for farge, størrelse og pris kan generere tusenvis av URL varianter fra bare noen hundre produkter.
- Interne søkeresultater. Søkeresultater på ditt eget nettsted trenger sjelden å crawles. De kan være nesten uendelige og endres hele tiden.
- Admin- og systemområder. Innloggingssider og backend-mapper har vanligvis ingen grunn til å bli crawlet.
For en norsk rørlegger med et WordPress nettsted på tolv sider er det lite å håndtere. Crawl volumet er neppe et reelt problem.
Se derfor på robots.txt som vedlikehold, ikke som et vekstverktøy. Den reduserer unødvendig crawling. Den skaper ikke synlighet.
Hvordan ser en robots.txt-fil ut?
Her er et så enkelt eksempel som det blir:
| User-agent: *Disallow: /admin/Sitemap: https://example.no/sitemap.xml |
Tre ting skjer her.
Den første linjen sier at reglene gjelder for alle crawlere. Den andre sier at ingenting i admin mappen skal crawles. Den siste linjen forteller crawlere hvor de finner XML nettstedskartet. Nettstedskartet viser URL-er du ønsker at søkemotorene skal oppdage.
Dette er et gyldig og enkelt eksempel. Hvilke regler nettstedet ditt trenger, avhenger av strukturen. Hvis du vil lære hele robots.txt syntaksen, inkludert User-agent, Disallow, Allow og jokertegn, kan du lese vår komplette guide til robots.txt. Foreløpig er poenget bare at filen er lett å lese. Du trenger ikke å være utvikler for å se på den og forstå omtrent hva den sier.
Hvor ligger robots.txt?
I roten av den aktuelle verten:
- https://example.no/robots.txt
Standard robots.txt filen må være tilgjengelig i roten av den aktuelle verten. En fil på https://example.no/pages/robots.txt er ikke nettstedets standard robots.txt-fil.
Én detalj mange overser, er at filen gjelder for den spesifikke verten den ligger på. En robots.txt fil på example.no styrer ikke shop.example.no. Et underdomene trenger sin egen fil.
Du kan sjekke robots.txt filen til et hvilket som helst nettsted ved å skrive adressen inn i nettleseren. Prøv med en konkurrent. Filen er offentlig med vilje.
Hvordan bruker Google robots.txt?
Når Googlebot vil crawle nettstedet ditt, sjekker den robots.txt filen først. Google mellomlagrer vanligvis robots.txt i opptil 24 timer, men den lagrede versjonen kan brukes lenger hvis Google ikke får hentet en ny versjon.
Hva som skjer videre, avhenger av hva Google finner.
- Filen finnes og inneholder regler. Google følger reglene for URL-ene de gjelder for.
- Filen finnes ikke. Google behandler nettstedet som fullt tilgjengelig for crawling. Dette er normalt og helt greit.
- Filen gir en serverfeil. Dette bør undersøkes. Google har egne regler for hvordan serverfeil i robots.txt håndteres, og vedvarende problemer kan påvirke crawling.
Dette er verdt å vite fordi det snur den vanlige tankegangen. Det er som regel helt greit å ikke ha en robots.txt fil hvis du vil at søkemotorer skal crawle de offentlige sidene dine. En robots.txt fil som ikke kan lastes inn, kan være mer problematisk enn å ikke ha en fil i det hele tatt.
Trenger alle nettsteder robots.txt?
Nei. Et nettsted fungerer helt fint uten en.
Hvis du har et lite bedriftsnettsted med noen titalls sider, og du ønsker at alle skal kunne finnes, er det ingenting du trenger å blokkere. Google kan crawle nettstedet ditt uten en robots.txt-fil. På et lite nettsted der alle viktige sider er offentlige, er dette ofte akkurat det du ønsker.
Det kan likevel være nyttig å ha en enkel fil av to grunner.
For det første kan du bruke den til å oppgi plasseringen til XML nettstedskartet. Det gir crawlere en ekstra måte å finne det på.
For det andre genererer mange innholdsstyringssystemer robots.txt automatisk. WordPress og Shopify er to vanlige eksempler. Derfor handler spørsmålet i praksis sjelden om du skal ha en fil eller ikke. Det viktigste er om du vet hva filen din faktisk sier.
Gå og sjekk den nå. Det tar ti sekunder, og noen ganger finner du noe overraskende.
Hva bør nybegynnere vite før de redigerer robots.txt?
Det er her feil kan føre til reelle SEO problemer.
- Én feil linje kan skjule hele nettstedet ditt. En enkelt Disallow: / kan blokkere crawling av hele nettstedet for crawlere som omfattes av regelen. Det ser uskyldig ut i en tekstredigerer. Effekten på trafikken din er langt fra uskyldig.
- Det er ikke et sikkerhetsverktøy. Google sier tydelig at robots.txt ikke er en mekanisme for å holde en side ute av Google. I tillegg er robots.txt filen offentlig. Hvis du skriver inn en privat mappe der, kan du faktisk avsløre hvor området du ønsket å holde privat, ligger.
- Bruk passordbeskyttelse for det som faktisk skal være privat. Hvis du vil holde en side ute av Google Søk, bør du bruke en noindex-direktiv og sørge for at Google kan crawle siden slik at Google kan se direktivet.
- Blokkerte sider kan fortsatt vises i søkeresultatene. Hvis andre nettsteder lenker til en side du har blokkert, kan Google fortsatt indeksere URL-en. URL-en kan vises i søkeresultatene uten innholdet på siden eller et vanlig søkeutdrag.
- Sjekk hva plattformen allerede har generert før du endrer noe. CMS-et ditt kan allerede håndtere dette på en god måte. Det er lett å ødelegge et nettsted hvis du overskriver filen uten å vite hva du gjør.
- Vær spesielt forsiktig ved redesign eller migrering. Utviklingsnettsteder blokkeres ofte helt slik at de ikke vises i søk. Noen ganger blir denne blokkeringen med over til det aktive nettstedet når den nye versjonen lanseres. Det er en alvorlig SEO-feil som kan gå ubemerket helt til trafikken faller.
Robots.txt og SEO: Hva påvirker den egentlig?
Robots.txt forbedrer ikke rangeringen din. Å blokkere URL-er forbedrer ikke automatisk rangeringen til URL-ene som fortsatt kan crawles.
Det robots.txt gjør, er å kontrollere tilgang. Det kan ha indirekte effekter, og de kan gå begge veier.
På et stort nettsted kan riktig bruk av robots.txt redusere crawling av URL-er som ikke trenger å bli besøkt. Brukes den feil, kan den blokkere sider du trenger at Google skal crawle. Da hjelper ikke engang godt innhold.
Det realistiske målet er derfor ikke å «optimalisere» robots.txt. Målet er å sørge for at filen ikke jobber mot deg.
For de fleste norske bedriftsnettsteder er riktig konfigurasjon ganske kjedelig. Den kan inneholde noen få fornuftige regler, eller den kan ikke trenge noen blokkeringsregler i det hele tatt. Når den fungerer som den skal, er det vanligvis ingen grunn til å endre den hele tiden.
Når bør du få hjelp med SEO?
De fleste bedrifter trenger aldri hjelp med dette. Men noen situasjoner kan være verdt en ekstra vurdering.
- Sider som tidligere dukket opp i Google, har plutselig forsvunnet
- Du har nettopp gjennomført en redesign, migrering eller endring av plattform
- Nettbutikken din genererer filter og parameter URL-er du ikke forstår
- Robots.txt inneholder regler som ingen i teamet kan forklare
- Search Console viser sider som er blokkert av robots.txt, selv om du forventet at de skulle være tilgjengelige
Det siste punktet fortjener oppmerksomhet. Search Console kan vise når viktige sider er blokkert for crawling. Sjekk derfor Search Console hvis du mistenker et crawlingproblem.
Sjekk filen din, og få en ekstra vurdering
Åpne dittdomene.no/robots.txt nå. Hvis filen er kort og gir omtrent mening, er alt sannsynligvis i orden.
Hvis den inneholder regler du ikke kan forklare, eller hvis sider har falt ut av Google uten en åpenbar grunn, bør du undersøke dette nærmere. Robots.txt er bare én liten del av teknisk SEO, men det er et av områdene der én enkelt linje kan koste deg mye trafikk.
Seostrategi.no hjelper norske bedrifter med tekniske SEO problemer, inkludert crawling og indeksering. Kontakt oss med domenet ditt og fortell hva du har lagt merke til, så kan vi forklare om robots.txt eller et annet teknisk problem bør undersøkes.
Vanlige spørsmål
Kan jeg se robots.txt filen til et annet nettsted?
Ja. Legg til /robots.txt etter domenet i nettleseren. Filen er offentlig tilgjengelig for alle.
Hva skjer hvis nettstedet mitt ikke har robots.txt?
Google behandler nettstedet som fullt tilgjengelig for crawling. For et lite nettsted der du ønsker at alt skal kunne finnes, er dette vanligvis akkurat det du ønsker.
Hva hvis robots.txt gir en 404 feil?
Hvis Google ikke finner en robots.txt-fil og får et normalt 404 svar, behandler Google vanligvis nettstedet som om det ikke har noen begrensninger for crawling. For de fleste små nettsteder er dette helt greit hvis du vil at søkemotorer skal crawle de offentlige sidene dine.
Kan robots.txt blokkere Google helt?
Robots.txt kan fortelle Googlebot at den ikke skal crawle URL-er som omfattes av reglene. Google følger vanligvis gyldige robots.txt-regler. Men blokkerte URL-er kan fortsatt vises i søkeresultatene hvis Google finner dem andre steder.
Fungerer robots.txt på HTTPS?
Ja. Hvis nettstedet ditt bruker HTTPS, bør robots.txt-filen være tilgjengelig i roten av HTTPS verten, for eksempel https://example.no/robots.txt. Hvis nettstedet bruker separate verter, som et underdomene, kan hver vert ha sin egen robots.txt-fil.
Kan robots.txt beskytte private sider?
Nei. Filen er offentlig og ber bare crawlere om å følge instruksjonene. Bruk passordbeskyttelse for innhold som faktisk trenger beskyttelse.
Vil redigering av robots.txt forbedre SEO-en min?
Ikke i seg selv. Den kan redusere unødvendig crawling på store nettsteder, og den kan gjøre reell skade hvis den er feil konfigurert. Men den forbedrer ikke rangeringen direkte.
Bør en nybegynner redigere robots.txt?
Det er helt greit å lese den. Å redigere den bør du bare gjøre hvis du forstår hva hver linje gjør. Risikoen ved en feil er større enn gevinsten ved å få alt riktig.
Hvor raskt behandler Google endringer i robots.txt?
Google mellomlagrer vanligvis robots.txt i opptil 24 timer, men tidspunktet kan variere. Ikke forvent at en endring påvirker crawling umiddelbart.
Kan robots.txt kontrollere AI crawlere?
Noen AI crawlere følger reglene i robots.txt, men det er ikke garantert at alle crawlere gjør det. Robots.txt er en instruksjonsfil, ikke en sikkerhetskontroll. Hvis du vil tillate eller blokkere en bestemt AI crawler, bør du sjekke crawlerens gjeldende dokumentasjon i stedet for å anta at alle roboter oppfører seg på samme måte.